Jeden kontrakt API dla backendu, webu i aplikacji mobilnej
BusiKM to trzy repozytoria i jeden kontrakt: schema.yaml w backendzie, typy generowane w web i mobile, a CI blokuje rozjazd przed develop i wydaniem.
Opublikowano: 5 min czytania
Autor: Łukasz Głowacz, Full-Stack Engineer · Read in English
Spis treści
BusiKM to trzy repozytoria: backend w Django, panel webowy w Next.js i aplikacja kierowcy w React Native. Jedna osoba i jeden kontrakt API między nimi. Gdy backend zmienia pole w odpowiedzi, web i aplikacja mobilna muszą się o tym dowiedzieć, zanim zmiana trafi do użytkownika, a nie po zgłoszeniu, że ekran się wysypał. W tym poście opisuję, jak trzymam ten kontrakt w jednym pliku i jak CI pilnuje, żeby repozytoria się nie rozjechały.
Jeden plik jako źródło prawdy
Plan wdrożenia z sierpnia ma w tej sprawie dwie krótkie decyzje. Pierwsza: jeden wspólny kontrakt API, plik schema.yaml w repozytorium backendu. Druga: na co dzień schemat bierzemy lokalnie, a ze stagingu dopiero przy wejściu na staging. Kolejność prac też jest ustalona: backend, potem web, potem mobile.
Wcześniej schema.yaml był w .gitignore. Każde repozytorium pobierało schemat z działającego backendu, lokalnego albo stagingowego, i nie było jednej wersji, do której można się odwołać. Od 1 września plik jest wersjonowany w repozytorium backendu i ma dziś 47 996 linii. Generuje go drf-spectacular z serializerów, widoków i routingu.
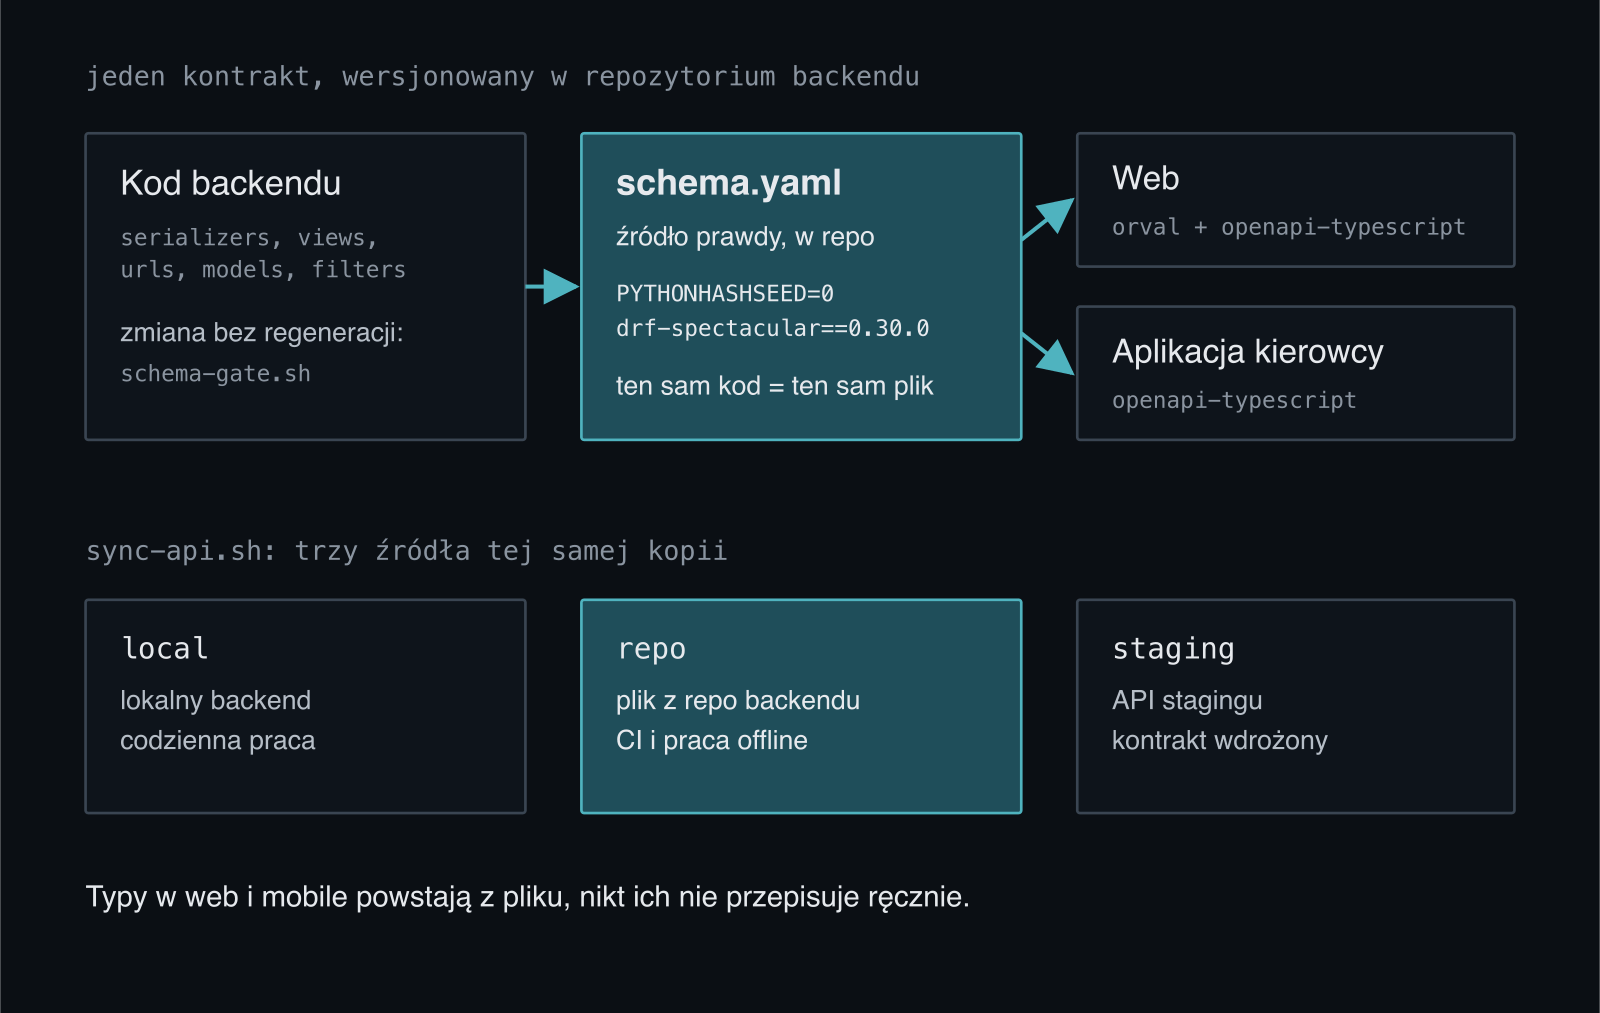
Web i aplikacja mobilna nie przepisują typów ręcznie. Web generuje z pliku typy (openapi-typescript) i gotowe hooki do pobierania danych (orval), aplikacja kierowcy same typy. Jeśli backend zmieni nazwę pola, kompilator TypeScript w webie i w mobile pokaże każde miejsce, które trzeba poprawić.
Ten sam kod musi dawać ten sam plik
Wersjonowany plik ma sens tylko wtedy, gdy generuje się deterministycznie. Pierwsza próba pokazała, że tak nie jest. Dwie generacje z identycznego kodu dawały pliki różniące się o 3294 linie, same przestawienia kolejności operacji. drf-spectacular iteruje po strukturach, których kolejność zależy od losowego ziarna haszowania w Pythonie. Bez stałego PYTHONHASHSEED=0 każda kontrola rozjazdu byłaby losowa od pierwszego dnia.
Druga przyczyna wyszła w CI przy tym samym PR. Zależność była zapisana jako zakres wersji. CI zainstalowało drf-spectacular 0.30.0, lokalnie było 0.29.0 i schemat wyszedł inny. Kontrola w CI słusznie to zgłosiła. Teraz generator jest przypięty dokładnie do jednej wersji, jako jedyna zależność w projekcie, której wynik trzymamy w repozytorium. Podniesienie jego wersji to osobny commit razem z regeneracją schematu.
Pre-commit, który nie przepuści zmiany bez schematu
Plik w repozytorium można zapomnieć zaktualizować. Dlatego backend ma hook pre-commit, który patrzy, czy commit dotyka czegoś, co kształtuje kontrakt API:
# Files that shape the API contract.
API_SHAPING=$(git diff --cached --name-only --diff-filter=ACMR | grep -E \
  '^(apps/.+/(serializers|views|urls|models|filters|enums|permissions)[^/]*\.py|apps/.+/(serializers|views)/.+\.py|config/urls\.py|config/settings/base\.py)$' || true)

if [[ -z "$API_SHAPING" ]]; then
  exit 0  # nothing that changes the contract
fi
# ...regenerate schema.yaml and block the commit if it differs from the staged one
Jeśli commit zmienia serializer, widok, routing, model albo filtr, hook generuje schemat od nowa do pliku tymczasowego, porównuje go z schema.yaml i blokuje commit, gdy się różnią. W komunikacie podaje różnice i komendę, która naprawia sprawę. Kod piszę głównie z Claude Code, więc taki hook jest dla mnie ważniejszy niż dla zespołu, który pamięta o regeneracji z nawyku. Agent nie musi pamiętać, bo commit bez schematu po prostu nie przejdzie.
Trzy źródła tej samej kopii
Web i mobile mają ten sam skrypt sync-api.sh, który pobiera kopię schematu z jednego z trzech źródeł:
local(domyślne): lokalny backend, do codziennej pracy, bo daje natychmiastową informację po zmianie w backendzie,repo: plik z repozytorium backendu, bez sieci, do porównań w CI i pracy offline,staging: API stagingu, dopiero przy wchodzeniu na staging, po wdrożeniu backendu.
Źródło prawdy jest jedno, a skrypt tylko wybiera, skąd wziąć jego kopię. Po pobraniu od razu generuje typy.
CI blokuje rozjazd tam, gdzie ma znaczenie
Najciekawsza decyzja dotyczy tego, kiedy rozjazd kontraktu jest błędem. Na gałęzi roboczej jest normalny: skoro praca idzie po kolei, backend często jest przed frontem. Blokowanie każdego PR z gałęzi feat/* tylko by przeszkadzało. Dlatego job contract-drift w web i w mobile ma regułę zależną od gałęzi docelowej:
# Rules per target branch:
#   feat/*         -> warn  (the backend is often ahead, local work)
#   develop        -> BLOCK, source: schema.yaml from the backend repo (no network)
#   staging, main  -> BLOCK, source: api-staging (the contract actually deployed)
target="${{ github.base_ref || github.ref_name }}"
case "$target" in
  develop)       source=repo;    blocking=true  ;;
  staging|main)  source=staging; blocking=true  ;;
  *)             source=repo;    blocking=false ;;
esac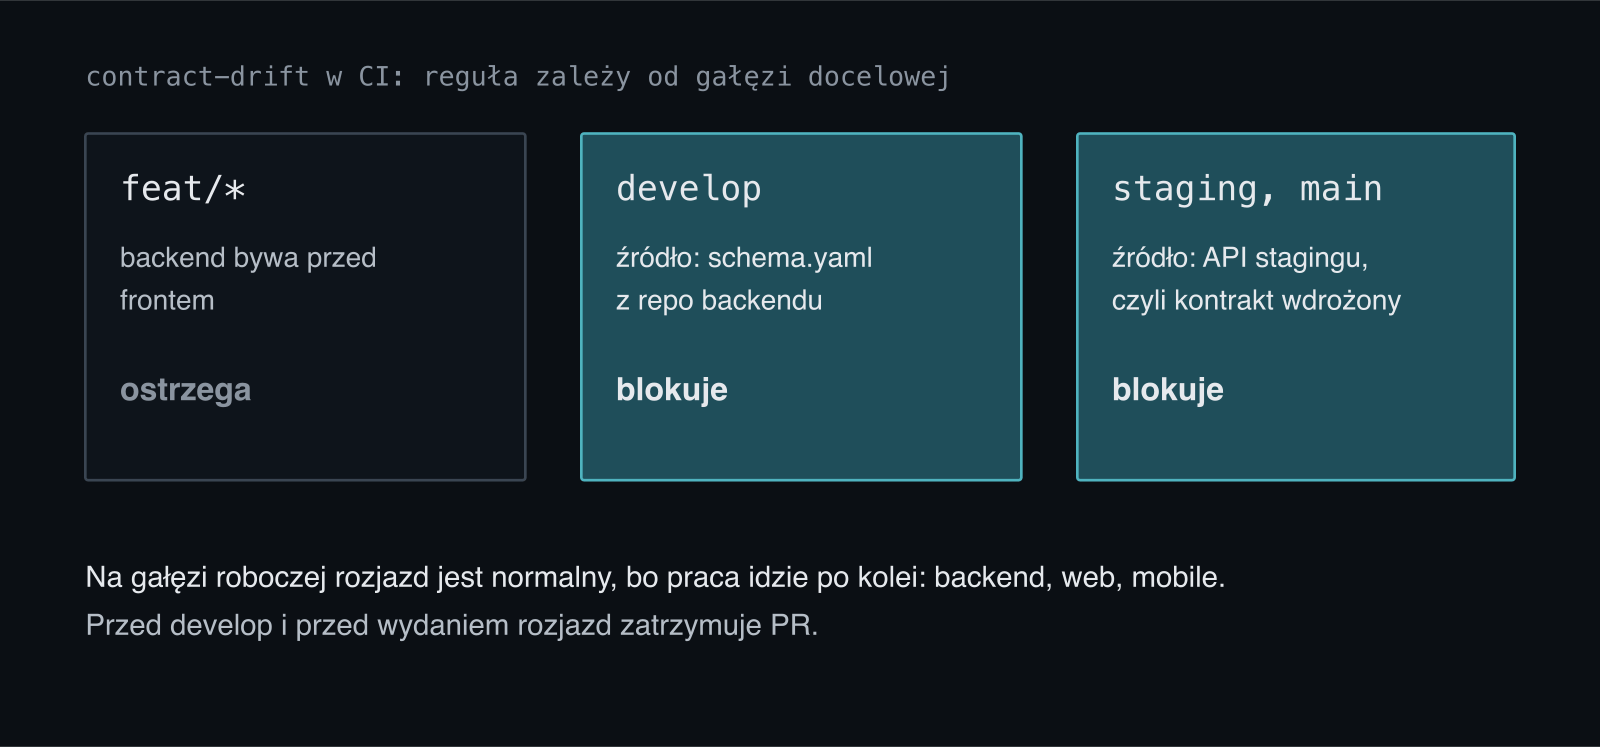
Przed develop porównanie idzie z plikiem w repozytorium, bez sieci, więc nie zależy od tego, czy staging akurat działa. Przed staging i main porównanie idzie z API stagingu, bo tam liczy się kontrakt naprawdę wdrożony, a nie ten zapisany w pliku.
Ile to kosztuje
Pierwszy koszt to dostęp między repozytoriami. Żeby CI webu mogło pobrać plik z repozytorium backendu, potrzebuje osobnego tokenu. Bez niego job nie przerywa builda, tylko zapisuje w podsumowaniu, że rozjazd na develop nie jest wykrywany. To świadomy wybór, żeby brak konfiguracji nie blokował całej pracy, ale też miejsce, w którym kontrola może po cichu nie działać.
Drugi koszt to starszy mechanizm, który działa obok. Po każdym merge'u do develop backend wysyła zdarzenie do repozytorium webu, a web po 30 sekundach pobiera schemat ze stagingu i otwiera automatyczny PR z aktualizacją. Te 30 sekund to założenie, że wdrożenie stagingu zdąży się skończyć. Jeśli nie zdąży, PR dostanie stary schemat. Kontrola rozjazdu i tak to wyłapie, ale to dobry przykład, że czekanie przez sleep to zgadywanie, a nie synchronizacja.
Z całej tej konstrukcji najbardziej opłaciło się jedno: kontrakt jest plikiem, a nie stanem działającego serwera. Plik można porównać w CI, wersjonować, przejrzeć w PR i odtworzyć dokładnie ten sam. Jeśli budujesz SaaS z osobnym frontem i aplikacją mobilną, zacznij od tego, gdzie leży kontrakt, zanim zaczniesz generować z niego typy. O tym, jak ta sama aplikacja kierowcy reaguje na zmiany zleceń na żywo, pisałem w poście o WebSockecie jako sygnale. Jeśli chcesz porozmawiać o architekturze swojego systemu, napisz do mnie.